연관 분석
연관 분석이란 무엇인가요?
연관 분석은 데이터 안에서 함께 나타나는 항목들의 관계를 찾는 분석 방법입니다. 데이터 마이닝에서는 보통 연관 규칙 학습(Association Rule Learning)이라고 부릅니다. 위키백과는 이를 대규모 데이터베이스에서 변수 사이의 의미 있는 관계를 찾는 규칙 기반 기계 학습 방법으로 설명합니다. 대표적인 예가 ‘장바구니 분석’입니다. 한 고객이 A와 B를 사면 C도 함께 사는 경향이 있는지를 확인하는 것입니다.
이 글은 키워드마스터 이용자처럼 블로그·스마트스토어·검색광고용 키워드를 찾는 분을 위해 썼습니다. 연관 분석의 기본 지표를 먼저 정리합니다. 이어서 같은 사고방식을 연관 키워드 확장과 선별에 어떻게 적용할 수 있는지 안내합니다. (확인 기준일: 2026년 9월 29일)
연관 분석의 기원과 핵심 지표
영문 위키백과에 따르면 연관 규칙은 1993년 Agrawal, Imieliński, Swami의 논문에서 소개되었습니다. 이 논문은 슈퍼마켓 POS 거래 데이터에서 상품 간 규칙성을 찾는 것을 목표로 했습니다. 이후 1994년 Agrawal과 Srikant가 발표한 Apriori 알고리즘이 대표적인 방법이 되었습니다. Apriori는 자주 함께 나타나는 항목 집합을 한 항목씩 넓혀 가며 찾습니다.
| 지표 | 정의(규칙 X ⇒ Y 기준) | 해석 |
|---|---|---|
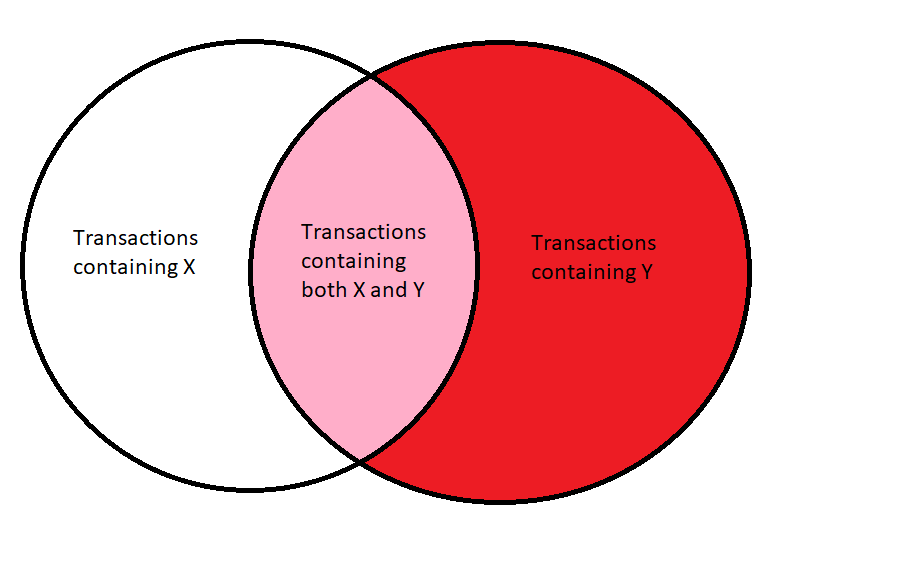
| 지지도(Support) | X와 Y가 함께 포함된 거래 수 ÷ 전체 거래 수 | 이 조합이 전체에서 얼마나 자주 나타나는지 |
| 신뢰도(Confidence) | X와 Y가 함께 포함된 거래 수 ÷ X가 포함된 거래 수 | X가 나타났을 때 Y도 나타날 조건부 확률 |
| 향상도(Lift) | supp(X∪Y) ÷ (supp(X) × supp(Y)) | 1보다 크면 우연보다 자주 함께 나타나고, 1에 가까우면 서로 독립에 가깝다는 뜻 |
세 지표는 함께 봐야 합니다. 신뢰도만 높은 규칙은 Y 자체가 원래 흔한 항목이어서 생긴 착시일 수 있습니다. 그래서 향상도로 ‘우연 이상의 관계인지’를 함께 확인하는 것이 일반적입니다.
이해를 돕는 가상 계산 예시
아래 숫자는 설명을 위해 만든 가상의 값이며 실제 데이터가 아닙니다.
- 전체 거래 100건 중 A 포함 20건, B 포함 25건, A와 B 동시 포함 10건
- 지지도(A⇒B) = 10 ÷ 100 = 0.10
- 신뢰도(A⇒B) = 10 ÷ 20 = 0.50
- 향상도(A⇒B) = 0.10 ÷ (0.20 × 0.25) = 2.0 → 우연보다 약 2배 자주 함께 등장
키워드 작업에서 ‘연관’이 의미하는 것
키워드 리서치에서도 같은 질문을 던질 수 있습니다. ‘이 키워드를 찾는 사람은 어떤 키워드도 함께 찾는가?’라는 질문입니다. 키워드마스터 분석 가이드는 연관 키워드를 네이버 검색광고 API가 돌려주는 관련 키워드로 설명합니다. 대량수집을 하면 이 키워드들이 자동으로 추가된다고 안내합니다. 다시 말해 연관 키워드는 사용자가 직접 규칙을 계산해 얻는 결과가 아닙니다. 검색 플랫폼이 제공하는 관련성 데이터를 바탕으로 한 목록입니다.
이 차이를 이해하면 도구를 더 정확하게 쓸 수 있습니다.
| 구분 | 데이터 마이닝의 연관 분석 | 키워드 도구의 연관 키워드 |
|---|---|---|
| 입력 데이터 | 분석자가 가진 거래·로그 데이터 | 검색 플랫폼이 제공하는 관련 키워드 데이터 |
| 결과 형태 | X ⇒ Y 규칙과 지지도·신뢰도·향상도 | 관련 키워드 목록과 검색량·CPC 등 지표 |
| 주요 용도 | 상품 배치, 교차 판매, 추천 | 콘텐츠 주제 확장, 롱테일 발굴, 광고 키워드 선정 |
| 주의할 점 | 향상도 없이 신뢰도만 보면 착시 가능 | 관련 키워드가 원래 주제에서 벗어날 수 있음 |
키워드마스터에서 연관 키워드를 확장하는 절차
아래 절차는 키워드마스터 공개 가이드인 연관검색어 추출 방법과 사용방법에 적힌 내용을 정리한 것입니다.
- 시드 키워드 입력: 검색창에 키워드를 입력하면 PC·모바일 검색량과 함께 연관 키워드가 표시됩니다. 연관 키워드를 클릭하면 해당 키워드로 바로 다시 검색할 수 있습니다.
- 대량수집 옵션 선택: 시드 키워드는 줄바꿈으로 여러 개를 넣을 수 있습니다. 옵션은 연관확장, 자동완성, 원문포함 세 가지입니다.
- 수집 규모 결정: 가이드는 1,000개, 10,000개, 무한수집 중에서 고를 수 있다고 설명합니다.
- 지표 확인과 필터링: 검색량, CPC, 블로그 글 수 등을 기준으로 조건을 설정합니다.
- 내보내기: 엑셀 다운로드나 키워드 복사로 결과를 정리합니다.
세 가지 수집 옵션 비교
| 옵션 | 기능(가이드 기준) | 이런 경우에 적합 |
|---|---|---|
| 연관확장 | 연관 키워드의 연관 키워드를 다시 검색해 2차·3차로 확장 | 주제의 주변부까지 넓게 살펴볼 때 |
| 자동완성 | 네이버 검색창 자동완성 데이터를 활용 | 실제 사용자의 입력 흐름을 반영하고 싶을 때 |
| 원문포함 | 시드 키워드를 포함한 결과만 수집 | 주제에서 벗어난 키워드를 줄이고 싶을 때 |
가이드는 두 가지 조합을 권장합니다. 주제를 정확히 유지하려면 연관확장 + 자동완성 + 원문포함을 켭니다. 최대한 많이 모으려면 연관확장 + 자동완성만 켭니다. 원문포함을 끄면 원래 주제에서 벗어난 키워드가 섞일 수 있다는 점도 함께 안내합니다.
연관 분석의 사고방식으로 연관 키워드 거르기
연관확장은 수집 단계가 깊어질수록 목록이 빠르게 늘어납니다. 이때 연관 분석의 세 지표를 그대로 계산할 수는 없습니다. 하지만 같은 관점을 빌려 목록을 점검하는 데는 도움이 됩니다. 아래 방법은 키워드마스터의 공식 기능이 아닙니다. 수집한 결과를 엑셀에서 정리할 때 참고할 수 있는 분석 관점입니다.
- 빈도(지지도 관점): 여러 시드 키워드의 연관 목록에 반복해서 나타나는 수식어(지역명, ‘가격’, ‘후기’, ‘방법’ 등)를 셉니다. 반복될수록 해당 주제군에서 공통된 검색 의도일 가능성이 큽니다.
- 조건부 관계(신뢰도 관점): 특정 시드에서 확장했을 때 어떤 수식어가 주로 따라붙는지 봅니다. 이렇게 하면 그 시드를 찾는 사람이 다음에 무엇을 궁금해하는지 가늠할 수 있습니다.
- 흔한 수식어 경계(향상도 관점): ‘추천’, ‘방법’처럼 어디에나 붙는 수식어는 자주 보여도 주제와의 특별한 관계를 뜻하지 않을 수 있습니다. 특정 주제에서만 두드러지는 조합을 따로 표시해 두는 것이 좋습니다.
이렇게 추린 후보는 수치로 한 번 더 검증합니다. 키워드마스터 가이드는 스코어 등급을 CPC 40% + 검색량 35% + 희귀성 25%로 산출하고 S부터 F까지 나눈다고 설명합니다. 희귀성은 블로그 글 수가 적을수록 높게 평가됩니다. 자세한 해석은 키워드 스코어 등급 보는 법에서 확인할 수 있습니다. 경쟁 강도는 키워드 경쟁률 확인하는 법에서 설명하는 ‘검색량 ÷ 발행량’ 비율로 판단할 수 있습니다. 이 비율이 1 이하라면 발행량이 검색량을 넘어선 과포화 상태로 볼 수 있습니다.
독자 상황별 활용 방향
| 상황 | 권장 옵션 조합 | 점검 포인트 |
|---|---|---|
| 한 주제로 연재 글을 기획하는 블로거 | 연관확장 + 자동완성 + 원문포함 | 반복되는 수식어로 글 시리즈를 묶고, 경쟁률로 발행 순서를 정함 |
| 새 카테고리를 탐색하는 운영자 | 연관확장 + 자동완성 | 주제에서 벗어난 키워드를 수작업으로 걸러 내고, 뜻밖의 인접 주제를 메모 |
| 검색광고 키워드를 고르는 광고주 | 원문포함 중심 | CPC와 검색량을 함께 보고, 관련성이 약한 키워드는 제외 |
| 수만 개 단위로 처리해야 하는 경우 | 대량 작업 기능 검토 | 이용 조건과 한도를 먼저 확인 |
대량 처리가 필요하다면 대량 키워드 안내를 참고하세요. 공개 페이지에 따르면 이 기능은 플래티넘 이상 요금제에서 쓸 수 있습니다. 작업당 최대 10만 개 키워드를 처리하며, TXT(한 줄에 한 개) 또는 CSV(첫 번째 열) 파일로 입력합니다. 외부 프로그램과 연동하려면 API 문서를 확인하세요. 이 API는 API 키 인증이 필요합니다. 요금제·한도는 바뀔 수 있으므로 이용 전에 가격안내에서 최신 조건을 확인하시기 바랍니다.
연관 분석 활용 시 유의할 점
- 연관은 인과가 아닙니다. 함께 검색된다고 해서 한 키워드가 다른 키워드의 원인이라는 뜻은 아닙니다.
- 데이터 출처의 한계를 기억하세요. 연관 키워드는 검색 플랫폼이 제공하는 데이터를 바탕으로 합니다. 따라서 제공 방식이나 시기에 따라 결과가 달라질 수 있습니다.
- 검색 의도를 직접 확인하세요. 수치가 좋아도 실제 검색 결과 화면을 보고 내 콘텐츠가 그 의도에 맞는지 확인하는 것이 좋습니다.
- 시기성을 고려하세요. 계절이나 이슈에 따라 함께 검색되는 키워드는 달라질 수 있습니다. 관련 내용은 키워드 트렌드 분석과 시즌 키워드 캘린더를 참고하세요.
요약
- 연관 분석은 함께 나타나는 항목의 관계를 지지도·신뢰도·향상도로 평가하는 방법입니다.
- 키워드 도구의 연관 키워드는 검색 플랫폼이 제공하는 관련 키워드 데이터로, 주제 확장과 롱테일 발굴에 활용됩니다.
- 키워드마스터에서는 연관확장·자동완성·원문포함 옵션을 목적에 맞게 조합하고, 스코어 등급과 경쟁률로 후보를 검증할 수 있습니다.
- 연관 분석의 관점(빈도, 조건부 관계, 흔한 수식어 경계)을 빌리면 늘어난 목록을 더 체계적으로 거를 수 있습니다.
참고 자료
- 위키백과 – 연관 규칙 학습
- Wikipedia – Association rule learning
- NAVER 검색광고 API 문서 저장소(GitHub)
- 키워드마스터 – 연관검색어 추출 방법
- 키워드마스터 – 분석 가이드
대표 이미지: ‘Association Rule Mining Venn Diagram’, 작성자 Mekaylatravis, Wikimedia Commons, CC BY-SA 4.0
안내: 이 글은 AI가 공개 자료를 바탕으로 작성한 정보 제공용 초안입니다. 기능·요금제·한도 등 변경될 수 있는 정보는 2026년 9월 29일에 공개 페이지에서 확인한 내용이므로, 이용 전에 해당 페이지에서 최신 내용을 다시 확인하시기 바랍니다.
목차